サンプルデータ:施策前後のスコア
実験データやアンケートの前後比較を分析する際、「とりあえずt検定をかければいい」と思い込んでいないでしょうか。現場のデータ分析では、サンプルサイズが小さい、あるいはデータが綺麗な釣鐘型(正規分布)を描かないケースが日常茶飯事です。前提条件を無視して無理にパラメトリック検定を適用すると、誤った有意差を導き出し、研究や施策の判断を大きく狂わせる危険を孕んでいます。
そこで必須となるのが、順位データに基づいて差を判定するウィルコクソンの符号順位検定です。本稿では、類似手法である「順位和検定」との違いから、正規性の検定を起点とする判断フロー、PythonやR、Excelでの実践手法まで、現場で迷わないための統計ノウハウを体系的に整理しました。
📌 【この記事の重要ポイントまとめ】
- 要点1:ウィルコクソンの符号順位検定は、「同一被験者の前後比較」など対応のある2群で正規性が満たされない場合に選ぶノンパラメトリック検定の王道。
- 要点2:名前が酷似する「順位和検定(マン・ホイットニーのU検定)」は独立2群を対象とする別手法であり、混同による誤用が現場で多発している。
- 要点3:外れ値の影響を受けにくく、Python(
scipy.stats)やR言語(wilcox.test)を用いれば数行のコードで正確なp値算出が可能。
【徹底比較】t検定・順位和検定との違いと使い分けの絶対ルール
データ解析の現場で最も頻発するトラブルが、「対応のあるt検定」「ウィルコクソンの順位和検定」「ウィルコクソンの符号順位検定」の混同です。これらは対象とするデータの関係性と分布の前提が根本から異なります。
まず押さえるべきは、比較対象が「対応のある2群の比較」なのか「独立した2群の比較」なのかという点です。同一被験者に対する「投薬前・投薬後」や「施策前・施策後」の数値差を追う場合は「対応あり」に分類されます。このとき、差の分布が正規分布に従うなら対応のあるt検定を、正規分布に従わない、またはサンプル数が極めて少ない場合はノンパラメトリック検定であるウィルコクソンの符号順位検定を選択するのが鉄則です。
一方、AグループとBグループという互いに無関係な被験者を比較する場合は「独立2群」となります。この場合のノンパラメトリック手法はウィルコクソンの順位和検定(実質的にマンホイットニーのU検定と同義)であり、符号順位検定とは計算アルゴリズムも検定統計量も全く別物です。
| 検定手法名 | 群の関係性(対応の有無) | 正規性の前提 | 主な評価指標・特徴 | 編集部の見解・適用基準 |
|---|---|---|---|---|
| ウィルコクソンの符号順位検定 | 対応あり(前後比較など) | 不要(差の対称性は仮定) | 差の絶対値の順位と符号 | 小標本かつ非正規分布の前後比較における第一選択肢 |
| 対応のあるt検定 | 対応あり(前後比較など) | 必要(差が正規分布に従う) | 平均値の差(パラメータ) | N数が30以上かつ外れ値がない場合の高検出力手法 |
| ウィルコクソンの順位和検定 (マン・ホイットニーのU検定) | 対応なし(独立した2群) | 不要 | 2群合算の順位合計 | 男女別、新旧UI別など別個の集団を比較する際に使用 |
なぜt検定が使えないのか?見落としがちな前提条件と外れ値リスク
統計学の教科書を開くと真っ先に紹介されるt検定ですが、実務データに無批判に適応するのはリスクを伴います。t検定が有効に機能するためには、「データの差が正規分布に従っていること」が必須条件だからです。
データの分布を確認するステップとして、事前にシャピロ・ウィルク検定などの正規性の検定を実施するのが標準的なアプローチです。有意水準5%(p < 0.05)で帰無仮説「データは正規分布に従う」が棄却された場合、そのデータにt検定を適用すると第一種の過誤(偽陽性)が生じる確率が跳ね上がります。
さらに現場で深刻なのが外れ値への対処法です。例えばWebサービスの利用時間データを10名分測定した際、1人だけ異常値(極端な長時間滞在)が含まれていたとします。平均値ベースで計算するt検定はこの1点に大きく引っ張られ、実態とは乖離した結果を導き出します。対してウィルコクソンの符号順位検定は、数値を「順位(ランキング)」に変換して処理するため、極端な外れ値が存在しても検定結果が破壊されにくいという強靭なメリットを持っています。
ウィルコクソンの符号順位検定の計算ロジック|帰無仮説からp値の解釈まで
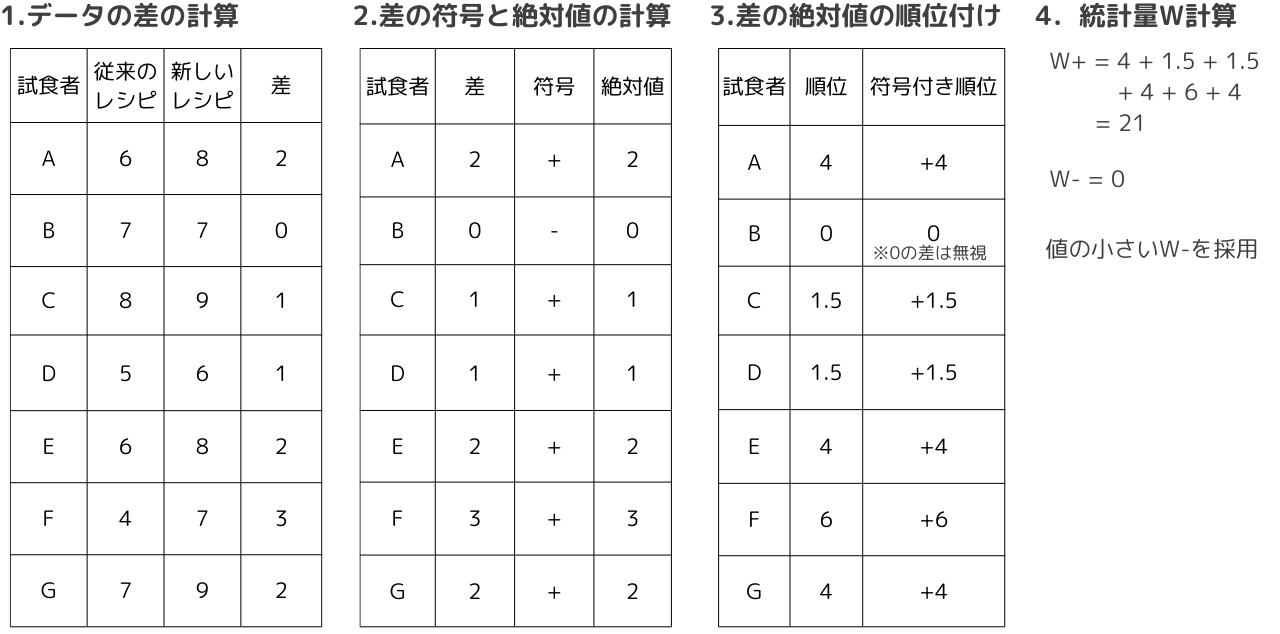
ブラックボックスになりがちな検定の仕組みですが、その計算手順は極めて直感的です。本手法では、以下のステップで統計量を導出します。
前提として、検定の枠組みは次の通り設定されます。
- 帰無仮説(H0):2群の母中央値に差はない(差の分布の中央値がゼロである)
- 対立仮説(H1):2群の母中央値に差がある(中央値がゼロではない)
手計算やエクセルでの計算手順は次の4ステップで進みます。
- ペアごとの差を算出:各被験者の「事後データ - 事前データ」を計算し、差が0のペアは除外する。
- 差の絶対値に順位を付与:符号を無視し、絶対値が小さい順に1, 2, 3…とランクを振る(同順位がある場合は平均順位を付与)。
- 符号の割り戻しと合計:元の差がプラスだった順位の合計($W^+$)と、マイナスだった順位の合計($W^-$)をそれぞれ計算する。
- 統計量Wの決定と有意差判定:$W^+$と$W^-$のうち小さい方を検定統計量$W$とし、サンプルサイズに応じた統計数値表と照合してp値の解釈と有意差を判定する。
出力されたp値が0.05未満であれば、帰無仮説を棄却し「前後で統計学的に有意な差が認められた」と判断します。平均値の差ではなく「中央値や順位傾向のシフト」を証明している点に注意してください。
【実践コード】Python・R言語・エクセルによる最短解析ガイド
現代のデータ解析において、検定を手作業で完結させる必要はありません。実務環境に応じた最適な実装手順を紹介します。
1. Pythonでの実装(scipy.stats)
Pythonでは科学技術計算ライブラリscipy.statsのwilcoxon関数を使用します。デフォルトで差が0のデータ処理やタイ(同順位)の補正を高精度に実行します。
from scipy import stats before = [55, 62, 70, 48, 53, 68, 75, 59] after = [60, 65, 68, 55, 59, 72, 81, 61] # ウィルコクソンの符号順位検定を実行 res = stats.wilcoxon(before, after) print(f"検定統計量: {res.statistic}, p値: {res.pvalue}") 2. R言語での実装(wilcox.test)
統計解析に特化したR言語では、標準パッケージに含まれるwilcox.test関数に引数paired = TRUEを渡すだけで完了します。
# サンプルデータ before <- c(55, 62, 70, 48, 53, 68, 75, 59) after <- c(60, 65, 68, 55, 59, 72, 81, 61) # paired = TRUE を必ず指定 wilcox.test(before, after, paired = TRUE) 3. エクセルでの計算手順
Excelには符号順位検定を直接出力する標準ワークシート関数が用意されていません(T.TEST関数のような単一関数は存在しない)。そのため、以下の手順を踏む必要があります。
①差の列を作成し、②ABS関数で絶対値を抽出、③RANK.AVG関数で順位付けを行い、④SUMIF関数で正負それぞれの順位和を集計します。サンプルサイズが20を超える場合は正規近似を行い、NORM.S.DIST関数を用いてp値を算出するのが通例です。少数サンプルの場合は計算ミスを防ぐためにも、PythonやR、またはJASPなどの統計GUIツールの併用を推奨します。
【実態検証】現場の研究者やアナリストが直面する3大落とし穴
データ解析の現場を取材すると、教科書通りの手順を踏んでいるつもりでも、致命的なミスに陥っているケースが後を絶ちません。現場アナリストから寄せられる代表的なトラブルは以下の3点です。
第1の落とし穴は「差がゼロのデータ(Tie)の大量発生」です。
アンケート調査などで5段階評価(リッカート尺度)を用いた場合、「変化なし(差が0)」と回答する層が全体の半数近くを占めることがあります。ウィルコクソンの符号順位検定の古典的アルゴリズム(Pratt法など一部を除く)では差が0のペアを除外して処理するため、有効サンプルサイズが激減し、検出力が極端に低下してしまいます。
第2の落とし穴は「差の分布の非対称性」です。
「ノンパラメトリック検定だからどんな分布でも万能」と誤認されがちですが、符号順位検定は「母集団における差の分布が対称であること」を仮定しています。差のヒストグラムが著しく歪んでいる場合、検定結果の信頼性は担保されません。その場合は、より制約の緩い「符号検定(Sign Test)」への切り替えを検討すべきです。
第3の落とし穴は「効果量(Effect Size)の未報告」です。
単に「p < 0.05 で有意差あり」と報告するだけでは、その変化が実務上どれほどの意味を持つのか伝わりません。符号順位検定では、検定統計量から算出する効果量 $r = |Z| / \sqrt{N}$ を併せて算出し、変化の大きさを客観的に明示することが論文発表や事業報告におけるデファクトスタンダードとなっています。
一般に知られていない盲点とネットの誤解
ウェブ上の解説記事や質問投稿サイト(Yahoo!知恵袋や統計コミュニティ)において、長年放置されている典型的な誤解が存在します。それは「サンプルサイズが小さければ、無条件でウィルコクソンの符号順位検定を使うべき」という言説です。
確かに符号順位検定は小標本でも計算可能ですが、統計的検出力には限界があります。例えば、サンプルサイズが5以下(N ≤ 5)の場合、両側検定においてどれほど劇的な差が生じていたとしても、数学的にp値を0.05未満に落とすことは不可能です(全ペアが同符号でも最小p値は0.0625)。極小サンプル下では、ノンパラメトリック検定を選択しても有意差を検出できない構造的限界がある点を知っておかなければなりません。
また、「正規分布ではない=ウィルコクソン」と機械的に判断するのも短絡的です。対数変換などのデータ変換を施すことで正規分布に近似できれば、情報量の多い対応のあるt検定を適用できる余地が残されています。データを安易に順位へ丸める前に、変換の可能性を模索することがデータ活用の幅を広げます。
【プロの結論】おすすめできる人・見送るべき人の特徴
以上の特性を踏まえ、本検定の適用適否を整理しました。
- 即座に選ぶべき人:
- アンケートのスコアや満足度など、順序尺度データの前後比較を行いたい
- サンプルサイズが10〜20程度で、データ内に明らかな外れ値が含まれている
- 正規性検定の結果、データの差が非正規分布であることが確定している
- 別の手法を検討すべき人:
- サンプルサイズが5以下で極端に少ない(検定力の限界があるため定性評価を優先すべき)
- 施策前後の変化量が「0」となる回答者が多数を占めている(符号検定やマクネマー検定を検討)
- サンプルの正規性が確認されており、より高い検出力で微細な差を捉えたい(対応のあるt検定を選択)
【ウィルコクソン の 符号 順位 検定】に関するよくある質問(FAQ)
Q1:ウィルコクソンの「符号順位検定」と「順位和検定」の名前が似ていて覚えられません。
A1:データに「符号(プラス・マイナス)」が付くかどうかで記憶してください。同一人物の前後比較では「引いた差」にプラスやマイナスの符号が生じるため「符号順位検定」を使います。男女の比較など別々のグループでは引き算ができないため符号がつかず、順位の合計を見る「順位和検定」を使います。
Q2:差が「0」のデータはどう扱えばよいですか?
A2:一般的な標準手順(Wilcoxonの原法)では、差が0のデータは除外してサンプルサイズ(N)を減らして計算します。ただし、差が0のデータがあまりに多い場合は検定結果が歪むため、差の正負のみに注目する「符号検定」を用いるか、Pratt法に対応した解析パッケージの利用を推奨します。
Q3:Excelで解析を完結させるのは難しいですか?
A3:不可能ではありませんが、関数を多段に組み合わせる必要があり、同順位(タイ)の処理で計算ミスが多発しがちです。確実性を重視するなら、Pythonのscipy.stats.wilcoxonや無料の統計解析GUIソフト(EZRやJASP)を利用する方が安全かつ工数も削減できます。
まとめ:今後の動向と失敗しないための判断基準
データドリブンな意思決定が定着した現在、とりあえず平均値を出してt検定にかけるというアプローチは、現場での誤判断を生む大きなリスクとなります。外れ値が存在する実務データや、正規分布が担保されない小規模サンプルにおいて、順位情報を活かすウィルコクソンの符号順位検定は必須の分析武器です。
「対応の有無を確認する」「正規性をチェックする」「外れ値の有無を見極める」というステップを省略せず、適切な検定手法を選択することこそが、信頼性の高いデータ検証への確実な近道となります。解析コードや統計ツールを賢く使いこなし、精度の高い分析結果を導き出してください。 (出典: ウィルコクソン の 符号 順位 検定(Yahoo!ニュース))


テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。